Wat gebeurt er eigenlijk met je gegevens als je op ‘verwijderen’ klikt?
Het verwijderingsproces wordt vaak beperkt uitgelegd door techaanbieders. Verschillende onderzoeken laten zien dat het onduidelijk is hoe dergelijke verzoeken worden afgehandeld en veelal geen duidelijke bevestiging volgt. Bij besturingssystemen (Windows, Android, iOS etc.), veel sociale mediaplatforms en abonnementen zijn de mechanismen voor verwijdering onduidelijk. We lopen daardoor veiligheids- en privacyrisico’s.
Een complicatie is dat veel gebruikers bang zijn om gegevens, bestanden, foto’s en video’s te verliezen, ook wel ‘diagraphofobie’ wordt genoemd. Dit digitaal hamstergedrag komt voort uit angst van mensen dat ze persoonlijke gegevens, zoals foto’s en muziek, kwijtraken door ze bijvoorbeeld per ongeluk te verwijderen.
Door deze onduidelijkheid van aanbieders en zorgen van gebruikers neemt de hoeveelheid persoonsgegevens toe die onbeheerd blijft staan. Die zijn vatbaar voor misbruik.
Verwijderen versus wissen
Een veelvoorkomende misvatting is dat verwijdering gelijkstaat aan verdwijning: de gedachte dat een verwijderd item, zodra het niet meer zichtbaar is, volledig is gewist en niet meer kan worden teruggehaald. Dit is grotendeels onjuist.
Als gebruikers bestanden verwijderen – door ze naar de prullenbak te verplaatsen en vervolgens definitief te verwijderen – worden de gegevens in feite niet gewist. Het systeem markeert de opslagruimte als herbruikbaar en past metagegevens aan om de koppeling met het bestand te verbreken. Maar de onderliggende inhoud is veelal terug te halen met de juiste middelen, vooral wanneer gegevens op meerdere systemen of apparaten zijn opgeslagen.
Tot de meer grondige manieren om gegevens definitief te verwijderen behoren fysieke vernietiging van het opslagmedium of het geheugen overschrijven met nieuwe data of de data versleutelen en de sleutel vernietigen.
Dergelijke methoden kunnen echter duur zijn en het opslagmedium onbruikbaar maken, bijvoorbeeld bij het overschrijven van data op magnetische media. De kenmerken van cloud infrastructuur vormen ook een uitdaging voor het veilig verwijderen van gegevens.
Zombie-accounts
Uitingen op openbare sociale netwerken worden mogelijk niet (volledig) verwijderd na het wissen omdat reacties, opmerkingen en internetarchieven dit belemmeren. De strekking van een verwijderde tweet kan bijvoorbeeld worden gereconstrueerd op basis van reacties en vermeldingen.
Een andere misvatting is dat het verwijderen van een app van een apparaat automatisch ook het bijbehorende account verwijdert. Gebruikers laten vaak mobiele app accounts in stand omdat ze niet (meer) weten dat ze bestaan, aangezien ze de bijbehorende app hebben verwijderd.
Deze zogenaamde zombie accounts of verlaten profielen bij winkels en dating-, financiële - en streamingdiensten blijven intact. Miljoenen gebruikers hebben zombieaccounts, met persoonlijke gegevens die kwetsbaar zijn voor diefstal en misbruik.
AI en ‘leerdata’
De exponentiële groei van AI roept een volgende kwestie op: Kunnen gegevens echt worden gewist nadat ze zijn gebruikt om AI-modellen te trainen? Machine learning-modules onthouden gemakkelijk de gegevens waarmee ze zijn getraind, maar ‘afleren’ is moeilijk.
In theorie hebben Europeanen een wettelijk vergeetrecht. Dit betekent dat zij kunnen verzoeken om de om alle door een platform of een bedrijf bewaarde persoonsgegevens volledig te verwijderen. AI-ontwikkelaars worden bijvoorbeeld volgens de Algemene Verordening Gegevensbescherming (AVG) van de EU beschouwd als verantwoordelijken voor verwerking en moeten aan deze verplichting voldoen.
Er zijn echter geen duidelijke richtlijnen hoe verwijdering binnen AI-systemen moet worden doorgevoerd. Toezichthouders kunnen om verwijdering verzoeken, maar AI-bedrijven kunnen aanvoeren datze hieraan niet kunnen voldoen omdat het technisch niet mogelijk is.
Verklaarbare verwijdering
Om de risico’s van onvolledige verwijdering tegen te gaan, bestaat volgens mij een dringende behoefte aan beknopte, toegankelijke en duidelijke informatie hoe verwijdering daadwerkelijk werkt.
Een mogelijke aanpak is ‘verklaarbare verwijdering’ – een protocol ontwikkeld door Marvin Ramokapane van het Britse National Research Centre on Privacy, Harm Reduction and Adversarial Influence Online (Rephrain) van de Universiteit van Bristol.
Het is de bedoeling om processen voor verwijdering transparanter en begrijpelijker te maken, zonder de gebruiker in één keer met te veel informatie te overweldigen.
Bij ‘verklaarbare verwijdering’ wordt de informatie onderverdeeld in zes categorieën: wat, hoe, wanneer, wie, waar en waarom (zie diagram). Elke categorie biedt de gebruiker beknopte informatie over dat deel van het proces.
De zes categorieën van ‘verklaarbare verwijdering’:
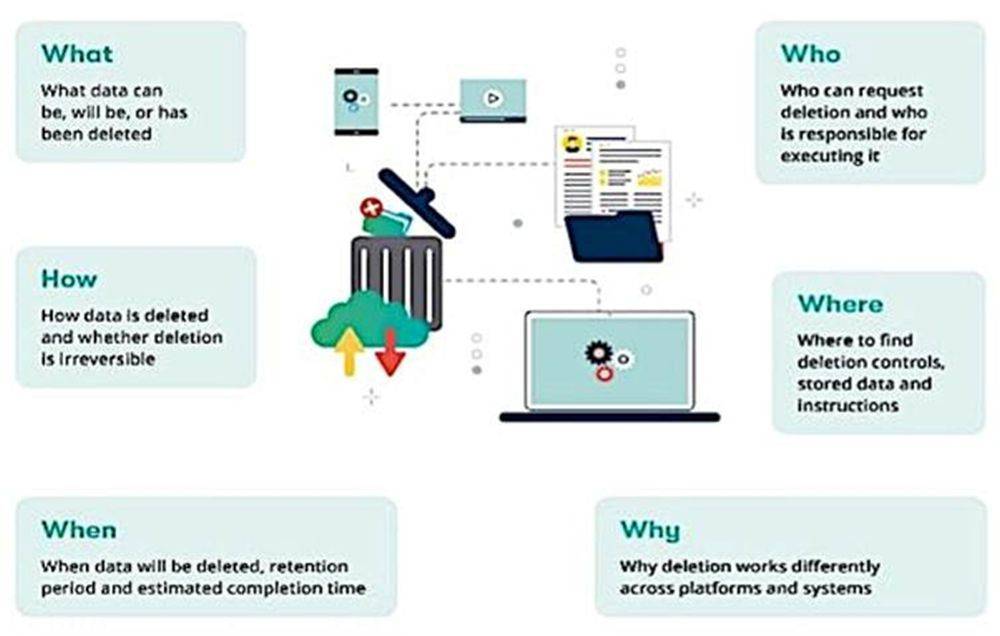
Marvin Ramokapane en Dana Lungu, CC BY-SA
‘Explainable deletion’ is bedoeld om gebruikers invloed te geven op mogelijke volgende stappen, om zelf een passende manier van verwijdering te kiezen, en te bevestigen dat hun keuzes daadwerkelijk zijn uitgevoerd. Het kan ook de angst voor het per ongeluk kwijtraken van gegevens wegnemen door mogelijk herstel aan te bieden.
Hoewel ‘explainable deletion’ in de praktijk nog niet is ingevoerd, zouden dienstverleners – zowel platforms als ontwikkelaars – hiermee het vertrouwen van gebruikers kunnen winnen. Dit raamwerk kan ook dienen als bewijs van naleving van de AVG-regelgeving en het vergeetrecht.
Aanbieders moeten worden verplicht om duidelijk uit te leggen wat ze precies opslaan en wat ‘verwijdering’ werkelijk inhoudt. Dat zou ons helpen om de accounts en gegevens te herkennen die een reëel risico vormen – en om noodzakelijke controle te krijgen over onze digitale voetafdrukken.
*) Dana Lungu is onderzoeker bij het National Research Centre on Privacy, Harm Reduction and Adversarial Influence Online (Rephrain) aan de University of Bristol in Engeland. Dit artikel verscheen eerder bij The Conversation
**) Photo by Jon Tyson on Unsplash

Netkwesties © 1999/2026. Alle rechten voorbehouden. Privacyverklaring
